概述
LIC-Muse 1.1 是一个从零自研的 256M 参数级语言模型。名称来自 Life and Inspiration and Creation:LIC 三个字母分别对应生命、灵感与创造; Muse(缪斯)是灵感与创造之神,也是模型主攻的艺术、哲学与文学之守护者。
| 项目 | 值 |
|---|---|
| 参数量 | 256,410,624(256.4M,权重共享嵌入) |
| 架构 | 16 层 decoder-only:RMSNorm → 因果 MHA(16 头)→ RMSNorm → SwiGLU |
| 宽度 / FFN / 上下文 | 1024 / 3168 / 1024 |
| 位置编码 | RoPE(base 10000) |
| 分词器 | 自研 byte-level BPE,词表 32,768(256 字节 + 5 特殊 token + 32,507 合并) |
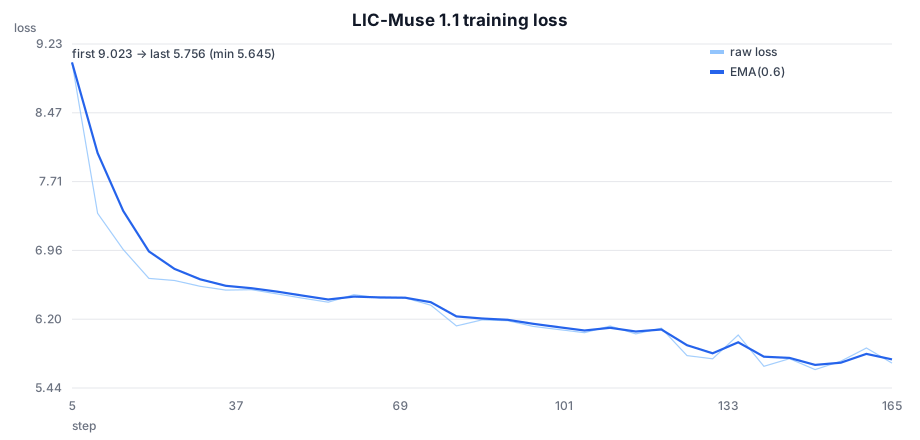
| 训练 | 纯 CPU(i5-1240P)3 小时,684,032 token,loss 10.6 → 5.72 |
| API | OpenAI 兼容(/v1/chat/completions 等),SSE 流式 |
快速开始
1. 环境要求
- Python 3.10+(开发验证环境为 3.13)
- PyTorch 2.2+(CPU 版即可,约 200MB)
- 磁盘:权重文件 1.03GB(fp32 safetensors)
- 内存:推理约 1.5GB;无需 GPU
2. 获取发行版
发行版目录 LIC-Muse-1.1/ 结构:
LIC-Muse-1.1/
├── model/            # config.json + lic-muse-1.1.safetensors
├── tokenizer/        # tokenizer.json
├── lic/              # 自研核心库(模型/分词器/推理)
├── scripts/
│   ├── serve.py      # OpenAI 兼容 API 服务
│   └── chat.py       # 命令行对话
├── examples/         # curl / OpenAI SDK 示例
├── requirements.txt
└── README.md
3. 安装与启动
pip install -r requirements.txt
python scripts/serve.py --port 8610
启动后会打印字符商标横幅与端点列表:
[serve] LIC-Muse ready: 256.4M params, vocab 32768
[serve] OpenAI-compatible API on http://127.0.0.1:8610
[serve]   POST /v1/chat/completions   POST /v1/completions
[serve]   GET  /v1/models             GET  /health
4. 第一次调用
curl http://127.0.0.1:8610/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"lic-muse-1.1","messages":[{"role":"user","content":"请用一句诗形容秋天"}],"max_tokens":120}'
5. 命令行对话
python scripts/chat.py                          # 交互式 REPL
python scripts/chat.py --once "生命的意义是什么?"   # 单次
echo "你好" | python scripts/chat.py            # 管道
REPL 内命令:/help /reset /temp /topp /topk /max /sys /lang /banner /exit。
API 参考
Base URL:http://127.0.0.1:8610(默认)。所有接口遵循 OpenAI 规范,
任意 OpenAI SDK 仅需修改 base_url。
端点总览
| 方法 | 路径 | 说明 |
|---|---|---|
| GET | /health | 服务状态、模型信息 |
| GET | /v1/models | 模型列表(OpenAI 格式) |
| POST | /v1/chat/completions | 对话补全,支持 SSE 流式 |
| POST | /v1/completions | 文本补全,支持 SSE 流式 |
| GET | /banner | 字符商标横幅(纯文本) |
POST /v1/chat/completions
| 字段 | 类型 | 默认 | 说明 |
|---|---|---|---|
| model | string | lic-muse-1.1 | 模型 ID |
| messages | array | 必填 | [{role, content}],role ∈ system/user/assistant |
| max_tokens | int | 200 | 最大生成 token 数 |
| temperature | float | 0.8 | 采样温度,0 为贪心解码 |
| top_p | float | 0.9 | 核采样阈值 |
| top_k | int | 50 | Top-K 采样 |
| repetition_penalty | float | 1.05 | 重复惩罚 |
| stream | bool | false | true 时返回 SSE 流 |
| stop | string/array | - | 停止词 |
非流式响应:
{
  "id": "chatcmpl-40809a8eae1f",
  "object": "chat.completion",
  "model": "lic-muse-1.1",
  "choices": [{
    "index": 0, "finish_reason": "stop",
    "message": {"role": "assistant", "content": "……"}
  }]
}
流式响应(SSE):
data: {"choices":[{"delta":{"role":"assistant","content":"水"}}]}
data: {"choices":[{"delta":{"content":"來"}}]}
data: [DONE]
POST /v1/completions
参数同上,用 prompt(string 或 string 数组)替代 messages;
响应 choices[0].text 为生成文本。
鉴权与 CORS
- 默认无鉴权(本地模式)。加
--key my-secret启动后,请求需带Authorization: Bearer my-secret。 - 已内置 CORS 头(
Access-Control-Allow-Origin: *),网页控制台可跨域调用。
http://127.0.0.1:8610;
如需从其他设备访问,请使用局域网 IP 或内网穿透,并在控制台「Base URL」中修改。
模型卡
架构(自研 LIC-Muse)
- RMSNorm 预归一化残差结构
- RoPE 旋转位置编码(base 10000)
- SwiGLU 前馈(gate/up/down 三矩阵,d_ff 3168)
- 因果多头注意力(16 头,head_dim 64),无 bias
- 权重共享嵌入:token embedding 与 LM 头共享
- 初始化 N(0, 0.02),输出投影按 1/√(2L) 缩放
分词器(自研 byte-level BPE)
- GPT-2 风格预切分 + CJK 单字单元(中文按字、英文按词/子词)
- 词表 32,768 = 256 字节 + 5 特殊 token + 32,507 合并
- 向量化批量合并训练(numpy),18 分钟完成
- 特殊 token:
<|endoftext|><|pad|><|user|><|assistant|><|system|>
训练数据
| 来源 | 内容 | 规模 |
|---|---|---|
| chinese-poetry | 全唐诗/宋词/诗经/楚辞/论语/孟子/乐府等 2246 个 JSON | 216.8 万行 |
| Project Gutenberg | 傲慢与偏见、福尔摩斯、沉思录、理想国、道德经、草叶集等 10 部公版书 | 8.4 万行 |
| 合成数学 | 四则运算、乘法表、数列、因数、几何、单位换算、应用题、闰年、奇偶、分数 | 10.7 万行 |
| 合成对话 | chat 格式多轮对话(诗词/美学/哲理/数学/创作/寒暄,中英双语) | 1.17 万段 |
| 合成美学/哲学 | 艺术评论 + 哲学格言 + 典籍名句印证 | 4.2 万行 |
合计 241.2 万行 / 111.9MB / 38,069,805 token(训练集)。
对话格式
<|system|>你是 LIC-Muse……<|endoftext|>
<|user|>请用一句诗形容秋天<|endoftext|>
<|assistant|>……<|endoftext|>
训练报告
完整报告见随附 docs/TRAINING_REPORT.md,此处为摘要。
配置
| 超参 | 值 |
|---|---|
| 优化器 | FrugalAdamW(自研,bf16 状态)β=(0.9, 0.95) |
| 学习率 | 峰值 4e-4,90s warmup,时间感知余弦衰减至 4e-5 |
| 权重衰减 / 梯度裁剪 | 0.1(≥2 维参数)/ 1.0 |
| 批次 | micro-batch 1 × 1024,梯度累积 4(4096 token/步) |
| 梯度检查点 | 开启(激活内存 ~0.3GB) |
| 硬件 | i5-1240P 纯 CPU,约 3.5–4GB 可用内存,PyTorch 2.14.1+cpu |
结果
| 指标 | 值 |
|---|---|
| 步数 / token | 167 步 / 684,032 token(180.4 分钟) |
| loss | 10.6 → 5.72(最佳单步 5.64) |
| 验证 loss | 5.96(step 100) |
| 吞吐 | ~65–70 token/s |
loss 曲线
样本(step 150,temperature 0.8)
提示:床前明月光,
不日此,以是。
《容山日,整以無可。
内容含然,不復何一。
仄平仄平仄平仄,平仄平仄仄仄平。
風月時,秋事生自知。
和人雲,
我如,自主人。
今日心來,不日何家
模型已学到古典诗词的平仄韵律、分行结构与常见意象字(風月山水雲春秋), 尚未掌握语义连贯性——符合 68 万 token 训练量下的预期能力。
代码示例
curl
curl http://127.0.0.1:8610/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"lic-muse-1.1","messages":[{"role":"user","content":"艺术是什么?"}],"stream":true,"max_tokens":120}'
Python(OpenAI SDK)
from openai import OpenAI
client = OpenAI(base_url="http://127.0.0.1:8610/v1", api_key="none")

resp = client.chat.completions.create(
    model="lic-muse-1.1",
    messages=[{"role": "user", "content": "请用一句诗形容秋天"}],
    temperature=0.75, max_tokens=200, stream=True,
)
for chunk in resp:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="", flush=True)
Python(标准库,无依赖)
import json, urllib.request
req = urllib.request.Request(
    "http://127.0.0.1:8610/v1/chat/completions",
    data=json.dumps({
        "model": "lic-muse-1.1",
        "messages": [{"role": "user", "content": "你好"}],
        "max_tokens": 80,
    }).encode(),
    headers={"Content-Type": "application/json"},
)
print(json.load(urllib.request.urlopen(req, timeout=120))
      ["choices"][0]["message"]["content"])
JavaScript(浏览器 / Node)
const resp = await fetch("http://127.0.0.1:8610/v1/chat/completions", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "lic-muse-1.1",
    messages: [{ role: "user", content: "生命的意义是什么?" }],
    stream: true, max_tokens: 120,
  }),
});
const reader = resp.body.getReader();
const decoder = new TextDecoder();
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  process.stdout.write(decoder.decode(value));
}
常见问题
Q:控制台提示连接失败?
确认本机已启动 python scripts/serve.py --port 8610,且控制台 Base URL 与之一致。
默认 http://127.0.0.1:8610 仅本机浏览器可达;换设备访问请用局域网 IP 或穿透。
Q:如何继续训练?
在完整工程目录执行 python scripts/train.py --resume --max-minutes 180,
会从 checkpoints/ckpt_latest.pt 恢复模型、优化器与学习率相位。
Q:支持 GPU 吗?
支持。模型为纯 PyTorch 实现,将 checkpoint 加载到 CUDA 设备即可
(torch.load(..., map_location="cuda"));训练脚本加 --batch-size 调大即可利用显存。
Q:为什么生成像"诗词拼贴"?
68 万 token 的训练量下模型学到了韵律与高频意象,但未学会语义规划。 这是从零训练 + 纯 CPU 算力下的诚实结果,扩大数据与步数可显著改善。
Q:R2 / 对象存储?
当前账户未启用 R2(需控制面板开通),站点使用 Cloudflare Pages 托管,不影响使用。